TokenByte 深度解析:一个 API 接入多种 AI 大模型,附快速接入教程与应用场景
Davis
相信最近大家都或多或少听说或聊过《秦始皇:朕有华夏全明星阵容》《持械入宋》等几款爆火的AI漫剧,这些作品的走红,让我们看到 AI 技术仅仅在视频创作领域就极具落地价值。
目前、为加速更多应用场景落地,越来越多企业及开发者开始尝试将 ChatGPT、Claude、DeepSeek、Seedance等文本视频模型的能力接入自己的应用,以提升自己的开发效率、丰富产品功能,并探索更多创新场景。
但在实际开发过程中,一个明显的问题是:不同模型服务商的 API 接口标准各异,SDK 互不兼容,调用方式千差万别。这导致开发者在集成多个大模型时,不得不为每个服务商编写独立的适配代码,不仅增加了开发复杂度,还带来了高昂的后期维护和切换成本。
一、为什么需要TokenByte这种AI 网关
例如前文提到的漫剧《朕有华夏》,AI在创作流程上大致:
- ChatGPT或Claude 负责故事大纲、角色设定、对白、分集剧本、镜头描述(剧本可能是购买的、这里是打个比方);
- GPTImage、万象或即梦 负责人物定妆、角色参考图、场景图、分镜关键帧设计与出图;
- Seedance、AiSphere或可灵负责图生视频、角色动作、镜头运动和场景动态化。
如果以上每个模型都单独接入,需要维护多个 API Key、多套调用逻辑,同时还需要关注:
- 接口稳定性
- 请求延迟
- Token 消耗
- 成本统计
- 模型切换
基于以上需求,我们面向企业及个人开发、创作者开发了一款AI 基础设施平台 —— TokenByte。
TokenByte 的核心定位是:一个 API,接入你需要的所有 AI 模型,让开发者无需重复适配不同模型服务。
二、TokenByte 是什么?
TokenByte 是一个面向开发者和企业的 多模型 API 聚合 平台。
简单理解:
传统模式:

TokenByte 模式:
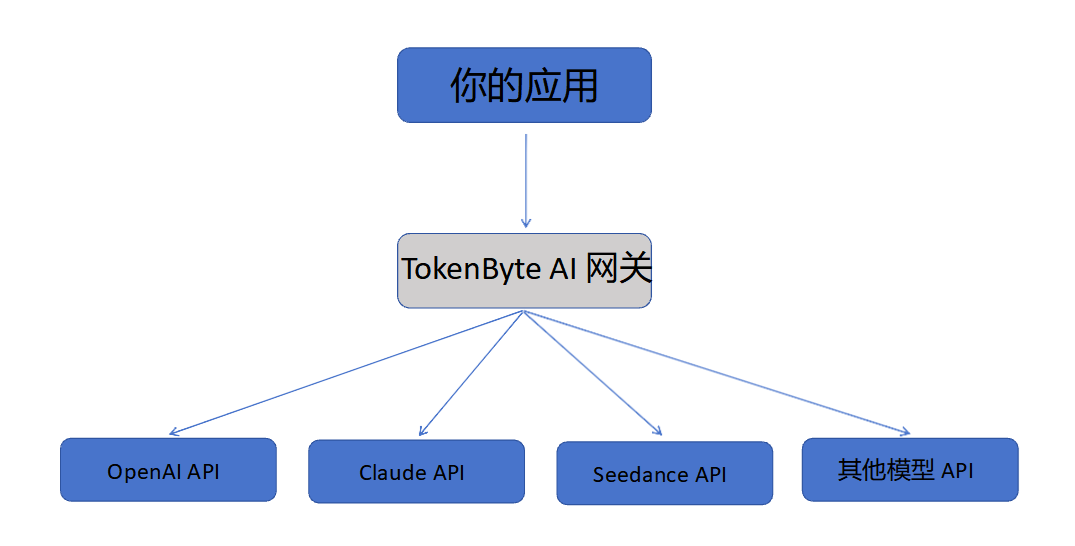
三、使用 TokenByte 的主要优势有哪些?
1. 统一 API 接口
- 标准化请求格式:无论调用 GPT-6、Claude 5 还是 DeepSeek,都使用相同的请求参数;
- 统一响应结构:所有模型返回统一格式的响应,简化客户端处理逻辑;
- 自动路由转发:根据配置自动将请求转发到对应模型服务商;
2. 多模型支持
目前 TokenByte 支持的大模型库包括:
| 模型提供商 | 模型名称 | 主要特点 | 成本 |
| OpenAI | GPT-6-Astra | 复杂推理、编程与智能体任务能力强 | 高 |
| Anthropic | Claude-Opus-5.5 | 擅长智能体编程与专业知识工作 | 高 |
| Gemini-4-Argon | 擅长复杂任务、数学、科学与编程 | 中 | |
| ByteDance | seedance-2.5 | 高质量音视频生成,长叙事与精准编辑 | 中 |
| DeepSeek | DeepSeek-V4.1-Flash | 推理快、成本低,支持多模态 | 低 |
| 开源/其他 | Qwen系列等 | 中文、多语言与编程能力强 | 低 |
3. 成本优化 与管理
- 统一计费:所有模型使用统一计费方式,按 Token 消耗结算
- 成本对比:实时展示不同模型的成本差异,帮助选择最优方案
- 用量监控:详细的 API 调用统计和 Token 消耗分析
四、使用流程
1. 注册与配置
注册过程简单快捷,邮箱即可注册。注册后即可创建自己所需的API Key
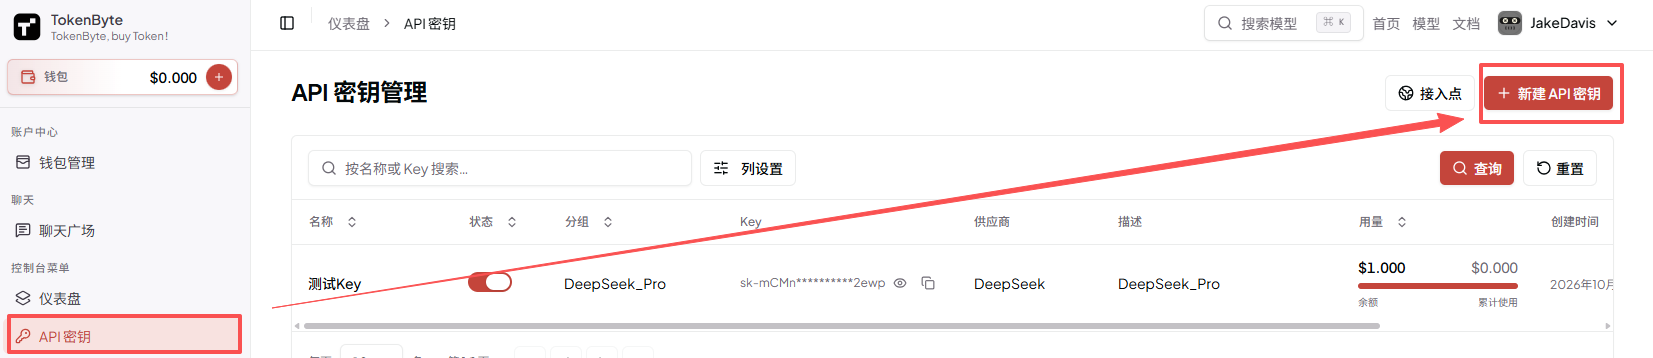
同时也支持绑定多个模型服务商的 API Key
提供详细的接入文档和 SDK 示例
2. API 调用体验
以下是一个简单的 Python 调用示例:
import requests
import json
import logging
import time
from typing import Optional, Dict, Any

# 配置日志
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')
logger = logging.getLogger(__name__)

class TokenByteClient:
    """TokenByte API 客户端,包含生产级错误处理与重试机制"""

    def __init__(self, api_key: str, base_url: str = "https://api.tokenbyte.ai/v1"):
        self.api_key = api_key
        self.base_url = base_url
        self.max_retries = 3
        self.retry_delay = 1  # 初始重试延迟(秒)

    def chat_completion(self,
                       model: str,
                       messages: list,
                       temperature: float = 0.7,
                       max_tokens: int = 1000) -> Optional[Dict[str, Any]]:
        """
        发送聊天补全请求,包含完整的错误处理和重试逻辑

        Args:
            model: 模型名称,如 "gpt-4", "claude-3-opus", "qwen-max"
            messages: 消息列表,格式同 OpenAI
            temperature: 温度参数
            max_tokens: 最大生成 token 数

        Returns:
            API 响应字典,失败时返回 None
        """
        url = f"{self.base_url}/chat/completions"
        headers = {
            "Authorization": f"Bearer {self.api_key}",
            "Content-Type": "application/json"
        }

        data = {
            "model": model,
            "messages": messages,
            "temperature": temperature,
            "max_tokens": max_tokens
        }

        for attempt in range(self.max_retries):
            try:
                logger.info(f"尝试第 {attempt + 1} 次请求,模型: {model}")

                # 发送请求,设置超时时间
                response = requests.post(url, headers=headers, json=data, timeout=30)
                response.raise_for_status()  # 检查 HTTP 状态码

                result = response.json()

                # 检查 API 级别的错误
                if "error" in result:
                    error_msg = result.get("error", {}).get("message", "未知错误")
                    error_code = result.get("error", {}).get("code", "unknown")
                    logger.error(f"API 返回错误: {error_msg} (代码: {error_code})")
                    self._handle_api_error(error_code, error_msg)
                    return None

                # 记录成功响应
                logger.info(f"请求成功,模型: {model}, 响应时间: {response.elapsed.total_seconds():.2f}秒")
                return result

            except requests.exceptions.Timeout:
                logger.warning(f"请求超时 (尝试 {attempt + 1}/{self.max_retries})")
                if attempt < self.max_retries - 1:
                    time.sleep(self.retry_delay * (attempt + 1))  # 指数退避
                else:
                    logger.error("达到最大重试次数,请求失败")
                    return None

            except requests.exceptions.ConnectionError as e:
                logger.error(f"网络连接错误: {e}")
                if attempt < self.max_retries - 1:
                    time.sleep(self.retry_delay * (attempt + 1))
                else:
                    logger.error("网络连接持续失败")
                    return None

            except requests.exceptions.HTTPError as e:
                status_code = e.response.status_code if e.response else "unknown"
                logger.error(f"HTTP 错误 (状态码 {status_code}): {e}")

                # 根据状态码处理
                if status_code == 401:
                    logger.error("API 密钥无效或过期,请检查配置")
                    return None
                elif status_code == 429:
                    logger.warning("请求频率超限,尝试退避重试")
                    if attempt < self.max_retries - 1:
                        time.sleep(5)  # 频率限制时延长等待
                    else:
                        logger.error("持续遇到频率限制")
                        return None
                elif status_code >= 500:
                    logger.warning(f"服务器错误 ({status_code}),尝试重试")
                    if attempt < self.max_retries - 1:
                        time.sleep(self.retry_delay * (attempt + 1))
                    else:
                        logger.error("服务器持续错误")
                        return None
                else:
                    logger.error(f"不可重试的 HTTP 错误: {status_code}")
                    return None

            except json.JSONDecodeError as e:
                logger.error(f"响应 JSON 解析失败: {e}")
                return None

            except Exception as e:
                logger.error(f"未知错误: {e}", exc_info=True)
                if attempt < self.max_retries - 1:
                    time.sleep(self.retry_delay * (attempt + 1))
                else:
                    return None

        return None

    def _handle_api_error(self, error_code: str, error_message: str):
        """处理特定的 API 错误码"""
        error_handlers = {
            "invalid_api_key": "API 密钥无效,请检查并更新",
            "insufficient_quota": "额度不足,请充值或检查使用量",
            "model_not_found": "请求的模型不存在或未授权",
            "rate_limit_exceeded": "请求频率超限,请稍后重试",
            "context_length_exceeded": "上下文长度超限,请减少输入",
        }

        handler = error_handlers.get(error_code)
        if handler:
            logger.error(f"API 错误处理建议: {handler}")
        else:
            logger.error(f"未知 API 错误码: {error_code}, 消息: {error_message}")

# 使用示例
if __name__ == "__main__":
    # 替换为你的 TokenByte API Key
    API_KEY = "YOUR_TOKENBYTE_API_KEY"

    client = TokenByteClient(api_key=API_KEY)

    # 准备请求消息
    messages = [
        {"role": "user", "content": "请用中文介绍一下 TokenByte 平台"}
    ]

    # 调用 API
    result = client.chat_completion(
        model="gpt-4",  # 可替换为 claude-3-opus、qwen-max 等
        messages=messages,
        temperature=0.7,
        max_tokens=1000
    )

    # 处理结果
    if result:
        content = result.get("choices", [{}])[0].get("message", {}).get("content", "")
        print("API 调用成功!")
        print(f"响应内容: {content[:200]}...")  # 只打印前200字符
        print(f"总 Token 消耗: {result.get('usage', {}).get('total_tokens', 'N/A')}")
    else:
        print("API 调用失败,请检查日志和网络连接")
3. 多模型切换测试
在实际测试中,我尝试了同一个应用切换不同模型:
 # 只需修改 model 参数即可切换模型
models_to_test = ["gpt-4", "claude-3-opus", "qwen-max"]

for model in models_to_test:
    data["model"] = model
    response = requests.post(url, headers=headers, json=data)
    print(f"{model} 响应时间: {response.elapsed.total_seconds():.2f}秒")
测试结果:
GPT-4:响应稳定,推理能力强
Claude 3 Opus:长文本处理优秀,逻辑清晰
Qwen-Max:中文理解出色,成本相对较低
4. 控制台功能
TokenByte 的控制台提供了丰富的管理功能:
- 实时监控:API 调用成功率、响应时间、Token 消耗
- 成本分析:按模型、按时间段的成本统计
- 日志查询:详细的请求/响应日志,便于调试
- 团队协作:支持多成员管理和权限控制
五、快速接入指南
本指南将详细说明从注册 TokenByte 到完成第一个 API 调用的完整步骤,帮助你快速上手。
1. 注册账号并获取 API Key
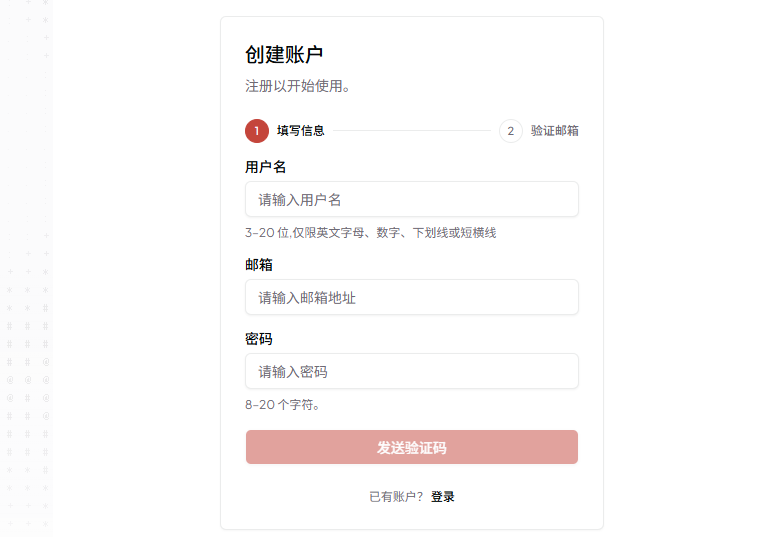
访问官网:打开 TokenByte 官网,点击“登录”。
选择注册方式:支持邮箱注册或联系客服快捷注册。
完成验证:根据提示完成邮箱验证或授权。
获取 API Key:
登录后进入控制台。
在左侧菜单找到“API 密钥” -> 点击界面右上角的“新建API密钥”,为密钥命名(例如“测试Key”),系统会生成一个以 sk_ 开头的 API Key

2. 环境准备(Python)
TokenByte 提供与 OpenAI 兼容的 REST API,你可以直接使用 requests 库调用,也支持使用官方的 Python SDK(如果提供)。
方案一:使用 requests(最通用)
确保已安装 requests 库:
pip install requests
方案二:使用官方 SDK(如果可用)
如果 TokenByte 提供了官方 Python SDK,可以通过 pip 安装:
pip install tokenbyte-sdk
3. 编写并运行你的第一个请求
以下是一个使用 requests 库的最小化示例,帮助你快速验证 API 连通性。
import requests
import json

# 1. 配置你的 API Key(替换为实际获取的密钥)
API_KEY = "tb_你的实际API密钥"
API_BASE = "https://api.tokenbyte.ai/v1"

# 2. 准备请求
url = f"{API_BASE}/chat/completions"
headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}
data = {
    "model": "gpt-3.5-turbo",  # 建议先用低成本模型测试
    "messages": [
        {"role": "user", "content": "你好,请用一句话介绍你自己。"}
    ],
    "max_tokens": 100
}

# 3. 发送请求
try:
    response = requests.post(url, headers=headers, json=data, timeout=30)
    response.raise_for_status()  # 检查HTTP错误
    result = response.json()

    # 4. 处理响应
    if "choices" in result and len(result["choices"]) > 0:
        reply = result["choices"][0]["message"]["content"]
        print(" 请求成功!")
        print(f"AI 回复: {reply}")
        print(f"本次消耗 Token: {result.get('usage', {}).get('total_tokens', 'N/A')}")
    else:
        print("  响应格式异常:", result)

except requests.exceptions.RequestException as e:
    print(f" 网络或请求错误: {e}")
except json.JSONDecodeError as e:
    print(f" 响应解析错误: {e}")
except Exception as e:
    print(f" 未知错误: {e}")
4. 测试与验证
1) 运行脚本:将上述代码保存为 test_tokenbyte.py,在终端运行:
python test_tokenbyte.py
2) 预期结果:如果一切正常,你将看到类似以下的输出:
 请求成功!
AI 回复: 你好,我是一个AI助手,很高兴为你服务。
本次消耗 Token: 45
3) 检查控制台:登录 TokenByte 控制台,在“仪表盘”或“使用日志”中应能看到刚才的调用记录,确认扣费正常。
4) 集成到你的应用
通过基础测试后,你可以:
探索更多模型:将代码中的 model 参数改为 "claude-3-haiku"、"qwen-plus" 等,体验多模型切换。
阅读官方文档:查看 TokenByte 官方文档,了解流式响应、函数调用、上下文管理等高级功能。
5. 常见问题排查
- 401 错误:API Key 错误或过期,请检查密钥是否正确,以及是否在控制台已启用。
- 模型不支持:确认 model 参数值在 TokenByte 支持的模型列表中。
- 网络超时:检查本地网络,或尝试调整 timeout 参数。
按照以上步骤,你可以在 5 分钟 内完成从注册到首次成功调用的全过程。TokenByte 的统一接口设计让后续集成其他模型变得极其简单,只需修改 model 参数即可。
六、TokenByte 如何帮助用户降低 AI 使用成本?
TokenByte 通过统一接入和集中化管理,帮助开发者与企业降低 AI 应用的开发、运维及模型调用成本。
对开发者的价值
- 降低开发成本: 统一 API 接口,无需重复适配不同模型,减少开发工作量。
- 提升开发效率: 统一调试、日志和监控,加快问题排查与产品迭代。
- 优化调用成本: 可根据任务需求配置性价比更高的模型,避免过度使用高价模型。
- 提高系统可靠性: 支持故障切换与负载均衡,保障服务稳定运行。
对企业的价值
- 统一管理: 集中管理模型接入、调用费用、预算与监控,降低管理成本。
- 控制业务风险: 支持多模型切换,降低对单一供应商的依赖。
- 优化资源投入: 按业务场景分配模型,提高资源利用率,减少不必要的开支。
- 加速业务创新: 快速接入和测试新模型,缩短开发周期,提升市场响应速度。
核心价值: TokenByte 通过统一接入、智能模型路由和集中化成本管理,帮助用户以更低的开发与运维成本,实现更高效、更灵活的 AI 应用。
七、TokenByte 适用哪些场景?
TokenByte 的通用设计使其适用于广泛的 AI 应用场景,从个人开发者的小型项目到企业级的大规模部署都能发挥价值。
1. 个人开发者
a. Google 评价自动化服务
场景描述: 餐厅、美容院、汽车维修店等本地商家需要主动回访客户并收集评价,但人工操作耗时,难以持续执行。
TokenByte 价值: 通过统一接入 AI 模型,自动分析客户反馈、发送评价邀请,并将负面反馈转交人工处理,帮助商家提升客户回访效率。
b. 高客单价业务的 AI 销售线索筛选
场景描述: 咨询顾问、教练及 B2B 企业经常面临销售线索质量参差不齐的问题,需要花费大量时间筛选潜在客户。
TokenByte 价值: 通过灵活调用不同 AI 模型,实现客户信息收集、意向分析、线索分类和预约流程自动化,帮助企业降低销售筛选成本,提高销售效率。
c. 电商品牌的 AI VIP 用户运营
场景描述: DTC 电商品牌需要提高老客户复购率,通过会员运营、新品推荐、补货提醒和专属活动,提升客户忠诚度与生命周期价值。
TokenByte 价值: 通过统一模型接口与智能路由,支持个性化消息生成、客户需求分析和营销内容自动化,帮助品牌提升用户运营效率与复购潜力。
2. 企业级应用
a. AI 漫剧制作
场景描述: AI 漫剧制作涉及剧本创作、角色设定、分镜设计、对白生成及视频制作,需要不同 AI 模型协同完成。
TokenByte 价值: 统一接入不同大模型,根据任务需求灵活选择模型,优化剧本创作、分镜规划和内容生成流程,降低模型调用与开发成本。
b. 软件开发
场景描述: 软件开发涉及代码生成、代码审查、Bug 排查、技术文档编写及测试用例生成,开发团队需要根据不同任务选择合适的 AI 模型。
TokenByte 价值: 通过统一 API 接入多个模型,支持灵活切换与效果对比,帮助开发团队提升编码效率、减少重复开发工作,并优化模型调用成本。
c. AI 企业知识库与办公自动化
场景描述: 企业日常需要处理大量内部文档、合同、报告、会议纪要及业务资料,人工检索、整理和分析信息耗时较长。
TokenByte 价值: 统一调用不同 AI 模型,支持文档总结、信息提取、知识问答和报告生成,帮助企业提升信息处理效率,降低重复性工作成本。
八、最后
TokenByte 的价值,不只是连接今天的大模型,更是为未来多模型协同的 AI 生态搭建基础设施。 无论是 AI Agent 的任务编排,还是未来更复杂的智能系统,都需要灵活的模型接入、智能路由与可控的调用成本。
当 AI 从“能够回答问题”走向“能够完成任务”,再走向“能够理解和模拟世界”,TokenByte 也有机会成为连接模型能力与真实业务需求的重要桥梁。